
【SDXL/kohya_ss】キャラクターLoRAは画像1枚で作れる?50枚学習やEpoch別比較で分かった違い
【要約】LoRA学習のポイントと画像枚数・Epoch比較
| 項目 | 画像1枚学習 | 約50枚学習 |
|---|---|---|
| 再現度 | 画風崩れ・別人のようになりがち | 期待通りのキャラクター再現が安定 |
| 特徴の分離 | 背景やポーズ・構図まで固定化されやすい | キャラクター固有の特徴のみ抽出可能 |
| 推奨度 | ×(特定ポーズ/画風抽出以外は厳しい) | ◎ キャラLoRA作成の基本 |
普段Stable Diffusion触ってると「LoRAってどう作ればいいの?」ってなるので備忘録もかねて。
そもそもLoRAとは何者?プロンプトをまとめただけじゃダメなの?
Stable Diffusionで画像生成してると、CheckpointとLoRAという言葉がセットで出てくる。
Checkpointがベースモデルなのは分かるけど、じゃあLoRAって何者なのか?
最初は「キャラクターや画風の特徴をまとめたプロンプトの圧縮版」みたいなものなのかなと思ってた。
でも実際に試してみると、プロンプトとLoRAは全然役割が違う。
| 項目 | 役割 |
|---|---|
| Checkpoint | 画像生成の土台となるモデル本体 |
| LoRA | ベースモデルに後付けして生成結果に影響を与える学習済みパラメータ |
| プロンプト | 「こんな画像を作って」とモデルに指示を出すテキスト |
LoRAはプロンプトをテキストとして圧縮保存したものではなく、ベースモデルの重みを調整する追加のパラメータ。
じゃあ実際キャラクターLoRAを学習させるとどうなるのか、色々試してみた。
画像1枚でキャラクターLoRAを作ったらダメなの?
とりあえず実験として、元画像1枚だけでキャラクターLoRAを学習させてみた。
今回の学習環境・ベース設定
- 学習ツール:kohya_ss
- ベースモデル:WAI-illustrious-SDXL(SDXL系)
- キャプション:自動生成されたものをほぼそのまま使用
結果としては、キャラクターっぽい雰囲気は出るものの、期待通りの見た目にはならなかった。
画風も元画像に引っ張られすぎてしまったり、ポーズや構図が固定化されがち。
もちろん、1枚でもLoRAの学習自体はできる。
ただ、1枚だと「キャラクター固有の特徴」と「その画像のポーズ・背景・画風」をAIが区別できないのが原因っぽい。
もしどうしても1枚から生成したい!ってときは以下のサイトが参考になるかも
https://note.com/mory909/n/nf0201c6feb13
今回は画風も維持しつつ自由なポーズで作らせたかったので、1枚だけだと厳しかった。。。
約50枚の学習画像を用意して再挑戦してみた
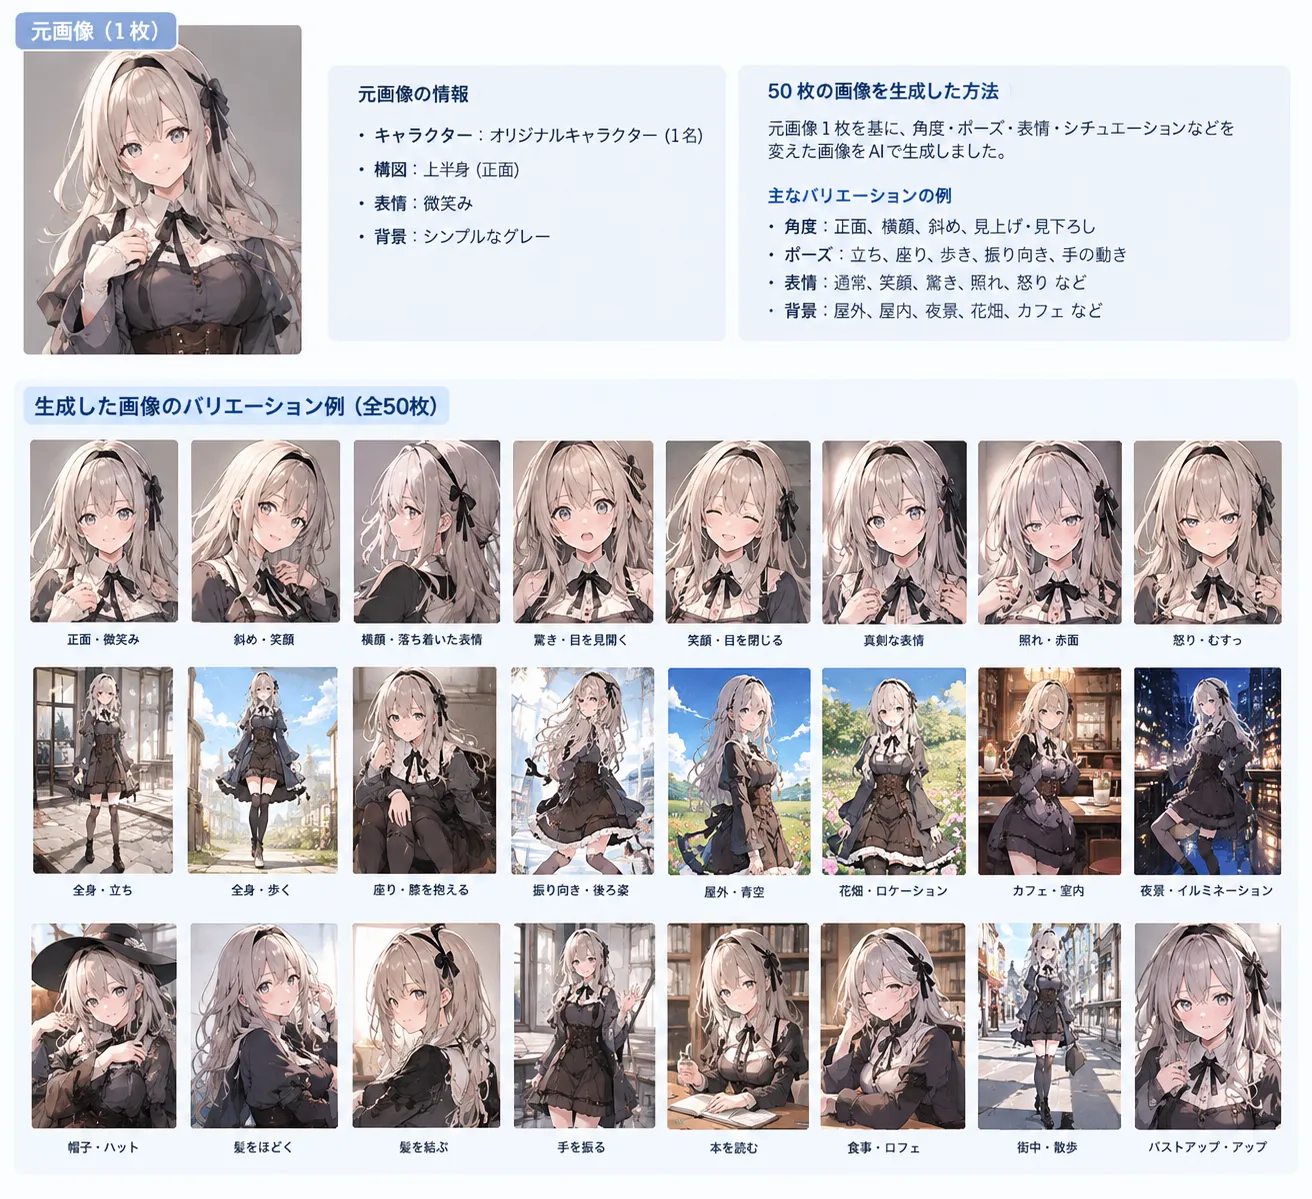
そこで、元画像1枚をベースに、角度・ポーズ・表情を変えた画像をAIで約50枚生成して学習データを作ってみた。
ただ生成した画像を全部使うんじゃなくて、別人のようになっちゃった画像や崩れてるやつはある程度除外して選別。
今回使用した kohya_ss の主要パラメータ
実際に50枚で学習させたときのパラメータ設定は以下の通り。
| パラメータ項目 | 設定値 | 備考・目的 |
|---|---|---|
| Pretrained model | WAI-illustrious-SDXL | SDXLベースモデル |
| Resolution | 1024, 1024 | SDXL標準解像度 |
| Enable buckets | ON | 縦横比が違う画像もアスペクト比維持で学習 |
| Train batch size | 1〜2 | VRAM容量に合わせて調整 |
| Epochs / Save every N | 10 / 1 | 全10Epoch。毎Epoch保存して比較用 |
| Mixed / Save precision | bf16 | 計算精度・保存精度 |
| Optimizer | AdamW8bit | VRAM節約しつつ高速学習 |
| Learning rate (Unet / TextEnc) | 0.0001 / 0 または 0.00005 | 学習率の基本指定 |
| LR scheduler | cosine | なだらかに学習率を減衰 |
| Network Rank / Alpha | 32 / 16 | キャラ+画風の両方をしっかり覚えさせる設定 |
| Shuffle caption / Keep n tokens | ON / 1 | 先頭のトリガーワード固定 |
| Cache latents / Gradient chkpt | ON / ON | VRAM節約設定 |
| Cross attention | sdpa (または xformers) | 高速化 |
学習設定はほぼこの設定に統一して、約50枚で再度LoRAを学習してみた。
すると今度は、期待通りのキャラクターを高精度で再現できるようになって一安心。
やっぱり画像枚数を増やして色んな角度・ポーズを見せてあげることで、AI側も「あ、これがこのキャラの特徴なんだな」と理解しやすくなるっぽい。
(もちろん50枚絶対必要というわけではなく、キャラの複雑さや画像の質によって変わる)
キャプションって何のためにあるの?
今回kohya_ssの自動キャプション機能を使ったけど、「キャプションって本当に必要なの?」と疑問に思うかも。
キャプションは「この画像には何が写っているか」をテキストで教えるラベルみたいなもの。
これがあると、AIが「服」や「背景」と「キャラクターの特徴」を切り離して学習しやすくなる。
Keep n tokens: 1 で先頭のトリガーワード(キャラ名など)を固定しつつキャプションを動かすことで、特定衣装やポーズに引っ張られにくくするのがコツ。
Epochって何?なんで大量のLoRAファイルができるの?
学習を回していると「Epoch(エポック)」という言葉が出てくる。
Epochは学習データを一巡した回数のこと。
kohya_ssで「Save every N epochs: 1」にしておくと、学習の途中でEpochごとにLoRAファイルが自動保存される仕組みになっている。
- Epoch 1のLoRA
- Epoch 2のLoRA
- …
- Epoch 10のLoRA
↓こんな感じでファイルがゴロゴロできる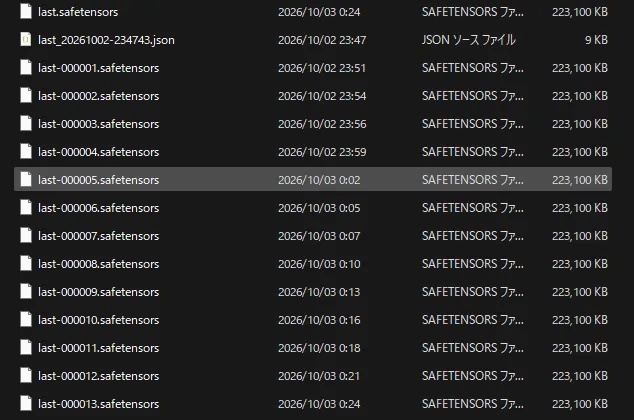
「じゃあどのEpochのLoRAが一番良いの?」と悩むことになるが、これは実際に生成して比較してみないと分からない。
PythonでEpochごとのLoRAを自動比較してみた結果
複数できたLoRAのどれを使えばいいか分からなかったので、ComfyUIとPythonを組み合わせて、各EpochのLoRAで同じ条件の画像を生成して一括比較するスクリプトを書いてみた。
※比較用のスクリプトはGitHubで公開中:ryo50/lora_compare
比較するときは以下のポイントを固定するのがコツ。
- Seed値を固定する
- 複数のプロンプト(ポーズや衣装)で生成する
- LoRAの適用強度(0.5〜1.0など)を変えて試す
- LoRAなしの素の生成結果と比較する
↓作成した比較表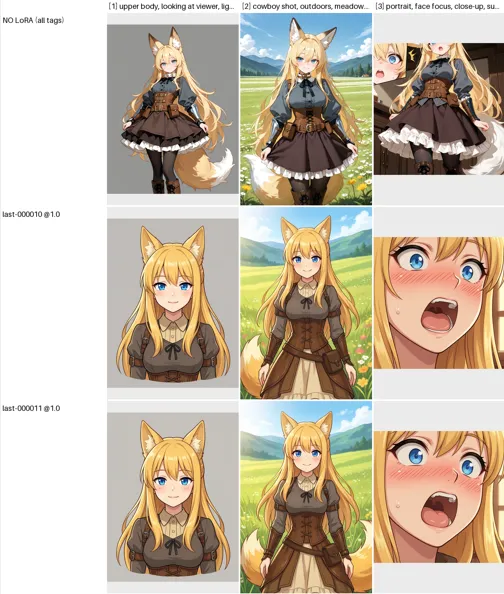
実際に比較してみて分かった挙動
初期のEpoch(1〜4あたり)だと、まだ学習が浅くてキャラクターの特徴や衣装の再現が甘い状態だった。
「過学習するかな?」と思って警戒していたが、今回の設定ではむしろ後半のEpoch 7〜10あたりが一番期待通りの再現度でしっくりきた。
見た目上「Epoch変わっても全然後差分出てないじゃん!!」みたいなケースも結構ある。
全量出力して目視比較しないと、本当に差分が出てるのか・どのEpochが最適なのかは分からない状態だったので、やっぱり全Epoch並べて比較するのは大事だなと痛感。
まとめ
今回キャラクターLoRAを作ってみて分かったポイント。
- LoRAはプロンプトの要約ではない:ベースモデルの動きを変える追加パラメータ
- 画像1枚より50枚:色んな角度・ポーズを用意した方がキャラの特徴を学習しやすい
- パラメータ設定を固める:Network Rank 32/16、AdamW8bit、cosineなどで再現性を確保
- 生成結果の比較が必須:今回の検証では後半(Epoch 7〜10)がベストだった。Python等で一括生成して比較表を作るのが一番確実
LoRA学習は「学習して終わり」じゃなくて、生成結果を見比べながらベストなEpochを選ぶまでがセットだなと実感した。
参考
- 今回のLoRA学習環境
- LoRA比較コード